TriCore Performance Counter性能计数器
TC1.6.2
每个 TriCore CPU 核都有自己的性能计数器,常用寄存器如下:
CCTRL
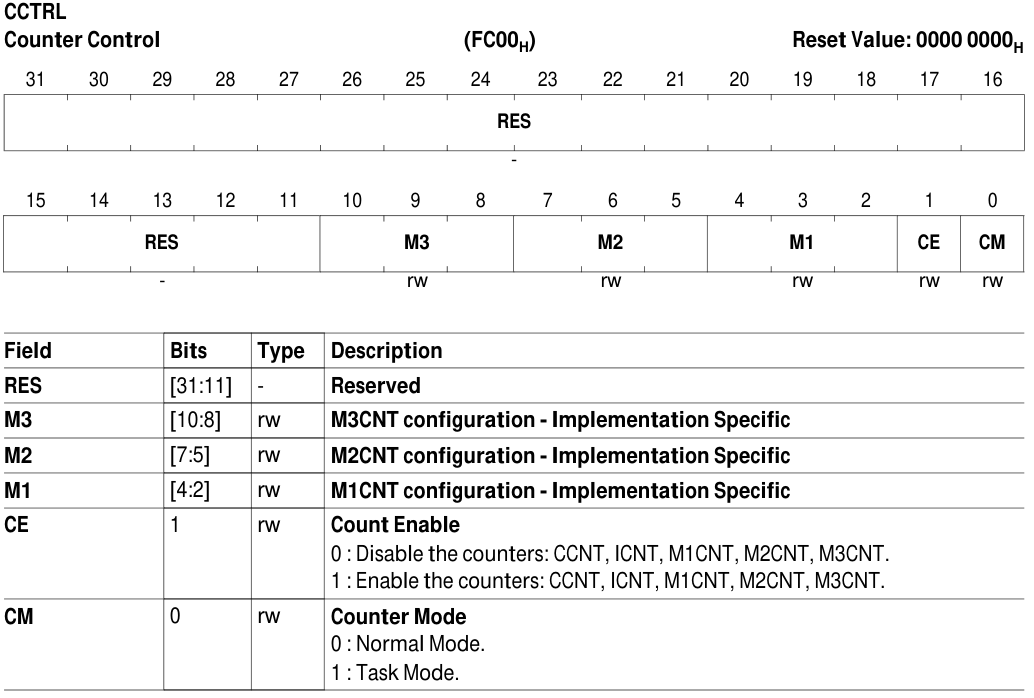
计数器控制寄存器,可配置计数模式,使能计数,计数事件,具体如下:
CE 是对 CCNT、ICNT、M1CNT、M2CNT、M3CNT 的整体使能。
CM 是针对这些计数器的模式选择;
Normal mode(CM=0):设置 CE=1 后就开始计数,直到清除 CE。
Task mode(CM=1):除 CE 外,还需要 debug event 逻辑给出相应的启动动作,计数器才会在指定窗口计数。
Task mode 本身不会自动识别操作系统任务。要只统计某个任务,需要另外配置debug event条件,使事件能代表你所需的任务或执行窗口
M1、M2、M3 计数事件具体查看具体芯片;
CCNT/ICNT/MxCNT
这三类寄存器结构均相同:
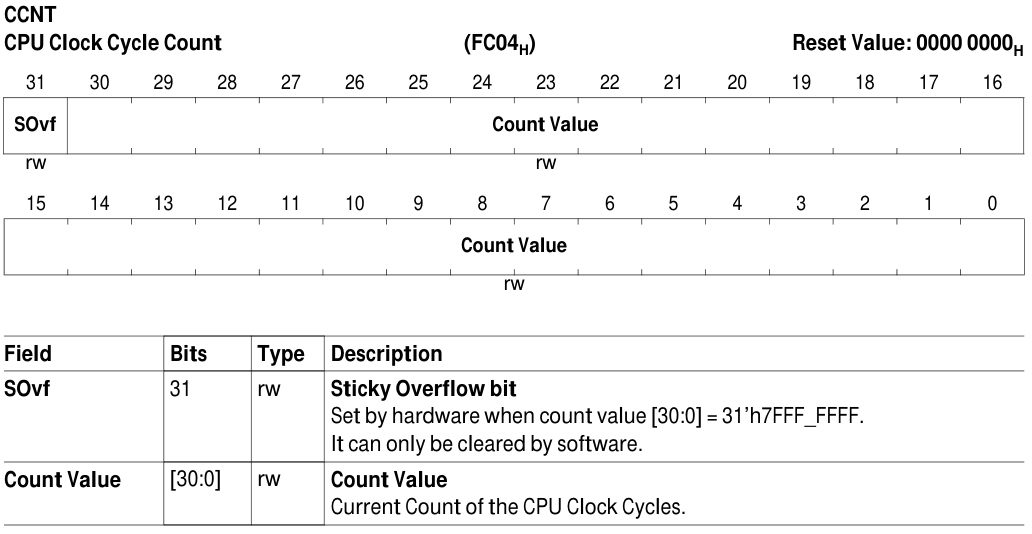
Count Value为使能后的CPU运行时钟周期,SOvf为溢出状态标志位;
需要注意的是:
写计数器前要先停表
计数器只有在未处于 counting mode 时才能写入。最稳妥的流程是:
清除
CCTRL.CE,停止所有性能计数器。写入需要清零或预置的计数器。
设置
M1/M2/M3和CM。最后设置
CE=1开始计数。
计数器工作时再写计数值,写入可能不会生效。(infineon.com)
读取计数值注意31位(溢出标志)
[31]:sticky overflow 标志。低 31 位回绕时该位被置位,之后保持置位,直到软件清除。
所以读取普通计数值时通常要屏蔽 bit 31
TC3xx
M1、M2、M3 分别选择对应多用途计数器要统计的事件。TC3xx 的常见映射如下;
流水线阻塞与并发效率类(Pipeline & Issue)
TriCore 是超标量(Superscalar)架构,内部有三条主要的并行流水线:整型流水线(Integer)、加载/存储流水线(Load-Store)和循环流水线(Loop)。以下指标用于评估 CPU 流水线是否顺畅:
IP_DISPATCH_STALL(整型流水线分发阻塞)字面意思:每当整型(Integer)指令分发单元因任何原因发生停顿(Stall)时,计数器在每个时钟周期加 1。
重点解读:主要负责加减乘除、逻辑运算的流水线卡住了。
常见原因:数据冒险(Data Hazard),比如当前算术指令需要用到的寄存器数据,上一条指令还没算出来(或者还没从内存读出来),CPU 只能干等。
LS_DISPATCH_STALL(加载/存储流水线分发阻塞)字面意思:每当加载-存储(Load-Store)分发单元因任何原因发生停顿时,每个周期加 1。
重点解读:负责读写内存、操作指针(地址寄存器)的流水线卡住了。
如果这个值很高,通常意味着代码中存在密集的内存访问冲突,或者外设/总线响应太慢,导致访存队列爆满,后续的读写指令发不出去。
LP_DISPATCH_STALL(循环流水线分发阻塞)字面意思:每当循环(Loop)分发单元因任何原因发生停顿时,每个周期加 1。
重点解读:TriCore 拥有硬件零开销循环(Zero-overhead loop)功能。
如果此项计数增加,说明循环跳转指令的执行受到了阻碍。
MULTI_ISSUE(多发射周期计数)字面意思:在任何一个时钟周期内,如果 CPU 同时发射(执行)了一条以上的指令,计数器加 1。
重点解读:这是衡量代码并发效率(好坏)的正向指标。TriCore 理想情况下可以在一个周期内同时执行一条算术指令(IP)和一条访存指令(LS)。这个值越高,说明你的代码(或编译器优化)写得越好,充分榨干了 CPU 的并行处理能力。
指令缓存类(Program Cache - PCACHE)
用于评估 CPU 从 Flash 读取代码指令的效率:
PCACHE_HIT(指令缓存命中)重点解读:取指单元(Fetch Unit)要执行的下一条代码,刚好在高速指令缓存(PCache)里找到了。这是理想情况,CPU 可以零等待(或极低延迟)继续执行。
PCACHE_MISS(指令缓存未命中/缺失)重点解读:要执行的代码不在 PCache 中,CPU 被迫发起一次总线请求(Bus Fetch),去慢速的 PFlash 中读取代码。
实战意义:通过
PCACHE_HIT / (PCACHE_HIT + PCACHE_MISS)可以算出指令缓存命中率。如果 Miss 很高,说明代码跳转太剧烈(比如函数调用层级太深、分支太多),建议将高频核心函数放到高频 RAM(如 PSPR)中运行。
数据缓存类(Data Cache - DCACHE)
用于配备了完整数据缓存的高性能内核(如 TC1.6P / TC1.6.2P),评估 CPU 读写全局变量、堆栈等数据的效率:
DCACHE_HIT(数据缓存命中)
CPU 要读写的数据已经在高速数据缓存(DCache)中,直接快速读写,不占用系统总线。
DCACHE_MISS_CLEAN(数据缓存未命中 - 干净行替换)
重点解读:要访问的数据不在 DCache 中,必须去主存(SRAM/Flash)里拿。好消息是,当前用来腾出空间的旧缓存行(Cache Line)是干净的(Clean,即只被读过,没被CPU修改过),所以直接丢弃旧数据,把新数据从内存读进来即可。产生一次总线读操作。
DCACHE_MISS_DIRTY(数据缓存未命中 - 脏行回写替换)
重点解读:这是最消耗性能的恶劣情况! 要访问的数据不在 DCache 中,且缓存已满。更糟的是,准备替换掉的旧缓存行是脏的(Dirty,即里面的数据被 CPU 修改过,还没来得及同步回内存)。
后果:CPU 必须先发起一次总线写操作(Writeback),把脏数据写回内存;然后再发起一次总线读操作,把新需要的数据读进来。一次 Miss 导致了两次总线传输,CPU 会严重卡顿。
数据读取缓冲区类(Data Read Buffer - DRB)
在早期的部分 AURIX 芯片中,为了节省成本和面积,某些高能效小核(如 TC1.6E)没有完整的 DCache,而是用了一个小型的“数据读取缓冲区(DRB)”来替代。
DRB_HIT(数据读缓冲命中)重点解读:在小核上,要读取的数据刚好在 DRB 缓冲区中,直接快速读取。
DRB_MISS(数据读缓冲未命中)重点解读:在小核上,要读取的数据不在 DRB 中,必须通过总线去主存读取。